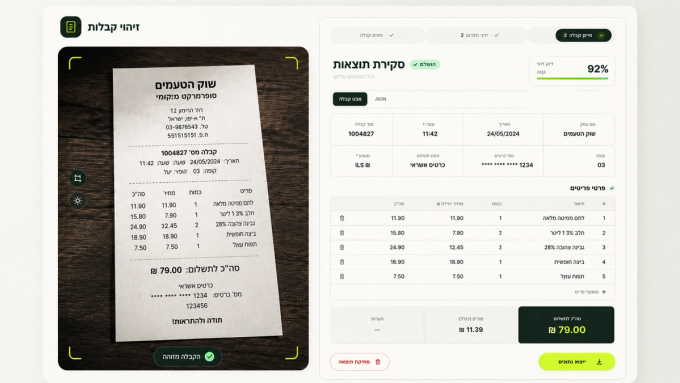
Die Belegerkennung wird deutlich schwieriger, wenn es kein einheitliches visuelles Layout gibt, auf das man sich stützen kann. In Israel ist diese Herausforderung besonders relevant: Belege verschiedener Unternehmen und Systeme können sich in Aufbau, Platzierung der Felder, Schriftarten und Datenformaten erheblich unterscheiden. Datum, Gesamtbetrag, Zahlungsart oder Einzelpositionen können von Dokument zu Dokument an unterschiedlichen Stellen stehen.
In einem unserer Projekte für ein israelisches Beratungsunternehmen mussten wir dieses Problem lösen, ohne für jedes Format eine eigene Erkennungsvorlage anzulegen. Wir haben einen Prototyp rund um ein multimodales LLM gebaut, das Belege und andere eingehende Dokumente lesen und die extrahierten Informationen als strukturierte Daten zur Weiterverarbeitung zurückgeben kann.
Arbeiten mit uneinheitlichen Dokumenten und unvollkommenen Bildern
Das System sollte gezielt bestimmte Informationen extrahieren, statt das Dokument lediglich zu transkribieren: Händlerangaben, Datum und Uhrzeit, Belegnummer, Währung, Zahlungsart, Einzelpositionen und Summen. Die Eingangsdaten waren in mehr als einer Hinsicht uneinheitlich. Selbst ähnliche Belege konnten unterschiedliche Layouts, Schriftarten, Abstände und Feldpositionen aufweisen, und manche enthielten zusätzlich handschriftliche Notizen, die neben dem gedruckten Text erfasst werden mussten.
Die Bildqualität brachte eine weitere Ebene an Komplexität mit sich. Statt mit sauberen, einheitlich gescannten Dokumenten musste das System mit Fotos unterschiedlicher Qualität arbeiten, die aus verschiedenen Winkeln aufgenommen waren. Der Erkennungsprozess musste also nicht nur unterschiedliche Dokumentstrukturen berücksichtigen, sondern auch uneinheitliche Ausgangsbilder.
Warum feste Vorlagen nicht ausreichten
Wenn Dokumente einer stabilen Struktur folgen, kann sich die Datenextraktion teilweise auf vordefinierte Regeln stützen — etwa indem ein Gesamtbetrag oder ein Datum in einem bestimmten Bereich der Seite gesucht wird. Dieser Ansatz passte hier nicht, weil dieselbe Art von Information je nach Beleg- oder Ticketformat an unterschiedlichen Stellen stehen konnte.
Für jedes Layout eigene Regeln aufzubauen und zu pflegen, wäre kaum skalierbar gewesen. Wir brauchten daher einen Ansatz, der die benötigten Informationen extrahiert, ohne für jedes Feld auf feste Koordinaten angewiesen zu sein.
Aufbereitung des Bildes vor der Erkennung
Vor der Erkennung durchlief jedes Bild einen Vorverarbeitungsschritt: hochwertiges 3,0×-Upscaling, Umwandlung in Graustufen und eine leichte Kontrastanpassung. So ließen sich niedrig aufgelöste oder schwer lesbare Bilder aufbereiten, bevor sie an das Modell übergeben wurden.
Das aufbereitete Bild wurde anschließend an ein multimodales LLM gesendet, das direkt mit visuellen Eingaben arbeitet. Statt zunächst Rohtext zu erzeugen und sich dann auf ein separates Set von Extraktionsregeln zu stützen, analysiert das Modell das Dokument im Kontext und extrahiert die benötigten Felder direkt.
Im Prototyp erkannte das System Händlerinformationen, Datum und Uhrzeit, Belegnummer, Währung, Zahlungsart, einzelne Artikel, Mengen, Preise und Summen. Auch handschriftliche Notizen flossen in die Erkennungsergebnisse ein. Das war wichtig, weil sie auf demselben Bild wie der gedruckte Inhalt stehen konnten.
Von der Erkennung zu strukturierten Daten
Den Text zu lesen, war nur ein Teil der Aufgabe. Das Ergebnis sollte auch über den Erkennungsbildschirm hinaus nutzbar sein. Deshalb wurden die extrahierten Informationen in einzelne Felder und Positionen gegliedert, statt als ein zusammenhängender Textblock zurückgegeben zu werden.
Nutzer können das Ergebnis prüfen, bei Bedarf einzelne Werte korrigieren und die Daten exportieren. Die strukturierte Ausgabe steht außerdem als JSON zur Verfügung und kann damit an andere Systeme übergeben werden, ohne dass der erkannte Text zuvor manuell geparst werden muss.
Damit wird die Dokumentenerkennung Teil eines umfassenderen Workflows statt einer isolierten Funktion. Derselbe Ansatz ließe sich zum Beispiel nutzen, um Lieferantenrechnungen und Belege zu verarbeiten, bevor die extrahierten Daten an interne Geschäftssysteme übergeben werden.
Was der Prototyp gezeigt hat
Derselbe Ansatz funktionierte bei Dokumenten mit unterschiedlicher Struktur und Bildqualität, auch bei Belegen mit handschriftlichen Notizen, ohne dass für jedes Format eine eigene Vorlage nötig war.
Noch wichtiger: Das Ergebnis ist nicht einfach aus einem Bild gezogener Text. Es sind strukturierte, bearbeitbare Daten, die geprüft und anschließend in einen Geschäftsprozess weitergegeben werden können. So wird die Dokumentenerkennung zu einem praxistauglichen ersten Schritt in einem größeren Automatisierungs-Workflow.
Stehen Sie in Ihrem Produkt vor einer ähnlichen Herausforderung bei der Dokumentenverarbeitung oder bei uneinheitlichen Eingangsdaten? Erzählen Sie uns davon, und wir besprechen, ob KI den Workflow vereinfachen könnte.